转载:AI时代,斯坦福计算机专业的学生在学什么?
转载声明:本文经原作者 liuyubobobo 授权转载。原文链接:微信公众号原文
AI 时代,很多同学都有这样的困惑:AI 写代码已经这么快了,计算机专业到底还要学什么?又该怎么学?
最近,斯坦福大学计算机系公布了 2026 年秋季的课表。
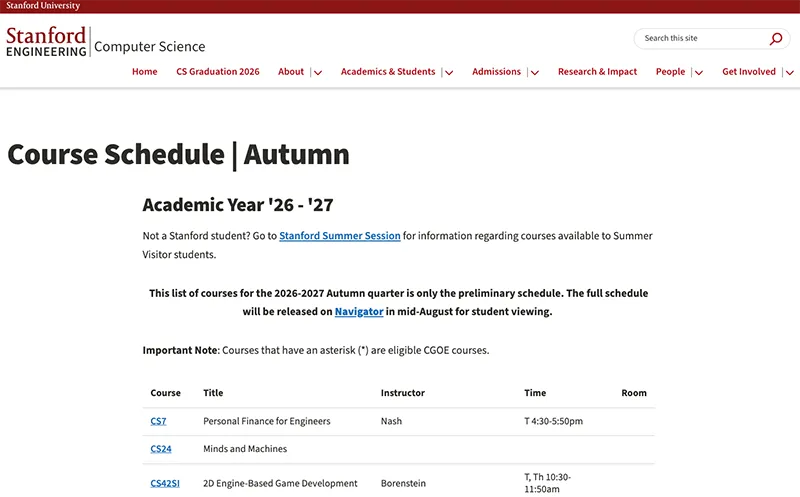
如果对这份课表的完整版感兴趣的同学,可以参考这里:
https://www.cs.stanford.edu/academics-courses-schedule-autumn-quarter
我顺着这份课表,梳理了其中一些课程的公开安排与变化,找到了一些值得分享的答案。
先看一个直观的比例。
剔除研究、实习等课程后,这份秋季课表还剩 80 个课程条目。
其中,AI 相关课程有 24 个,占 30%;
非 AI 课程有 56 个,占 70%。
AI 课程和非 AI 课程的比例大致是三七开。
我们先聊非 AI 课程。
这里所谓的非 AI 课程,基本涵盖了大家熟悉的传统计算机专业知识。
比如:编程语言、算法、数据结构、数学、操作系统、网络、数据库、图形学,等等等等。
也就是说,在 AI 大行其道的今天,这份课表里依然有七成课程,属于传统计算机专业的学习内容。
我个人觉得这是很合理的。
我一直认为,无论在哪个领域,专业和不专业的核心区别,都在于对基础的理解。
缺乏基础,就只能做一个盲目的使用者。面对 AI 生成的代码,也只能“知其然,不知其所以然”。既无法识别隐蔽的性能瓶颈与安全漏洞,也难以在程序报错或失效时定位根本原因。
更重要的是,基础知识里还藏着一个领域的发展历史和发展方向。只有理解基础,才能看清哪些问题还没解决,哪些问题更值得解决,进而推动这个领域往前走。
让我更感兴趣的一个问题是:在 AI 时代,这些基础课程的学习内容和学习方法是否有了变化?
我总觉得,在 AI 时代,很多课程的学习方式都会发生本质的变化。
比如学习一门编程语言,记忆语法细节、熟悉各种函数的写法,还需要花那么多时间吗?学习的重心,是不是应该更多地放在理解程序的运行逻辑,以及如何把实际问题转化为程序可以解决的问题上?
语法当然还要学。但学到什么程度,怎么学,或许都值得重新讨论。
从目前看到的公开材料来说,我还没发现斯坦福对这些基础课的学习方式做出大范围、系统性的调整。大部分课程都仍在使用非 AI 时代的经典教材。
但我相信,未来很多学科的学习内容和学习重点,都会发生翻天覆地的变化。
只是这还需要时间。
但在一些课程的具体的作业里,我们已经能看到一些课程正在尝试把 AI 融入其中。
比如,编程基础课 CS106A 布置了一份很有想象力的作业,叫 Infinite Story(无限故事)。
学生用函数和字典这些非常基础的知识,搭起一个冒险故事。玩家走到一个还不存在的场景时,需要用程序调用 AI,把新场景生成出来。
大家可以把它想象成一本边读边长出新章节的互动小说。
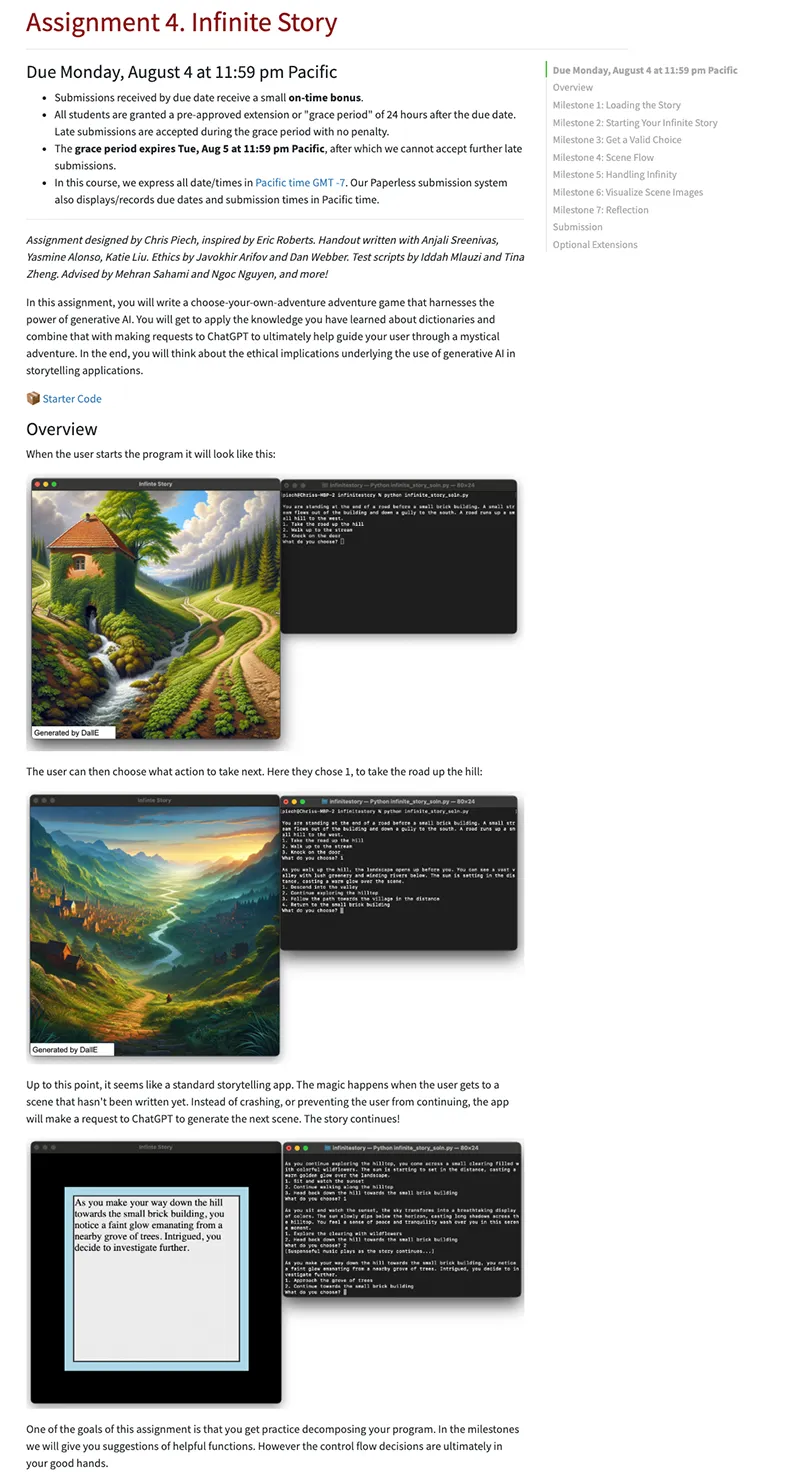
作为一份编程基础课的大作业,用到的技术都很基础。可它能让刚学编程的同学感受到编程的乐趣:原来,用最简单的计算机知识,也可以接入最先进的 AI 工具,借助 AI 的力量,做出一些很酷、很有创意的东西。
暂时还没有那么多计算机基础课,可以这样有趣地把 AI 融合在其中。
更多基础课程讨论的是:作业能不能用 AI?能用到什么程度?
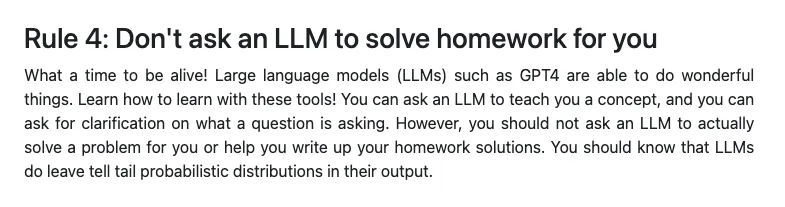
最常见的规定是:可以让 AI 解释概念、澄清题意,但不能让它解题或帮助撰写作业答案。比如概率论课程 CS109。
涉及编程时,大多数基础课也会明确要求学生避免让 AI 生成代码。
CS107(计算机组成与系统)就是其中之一。
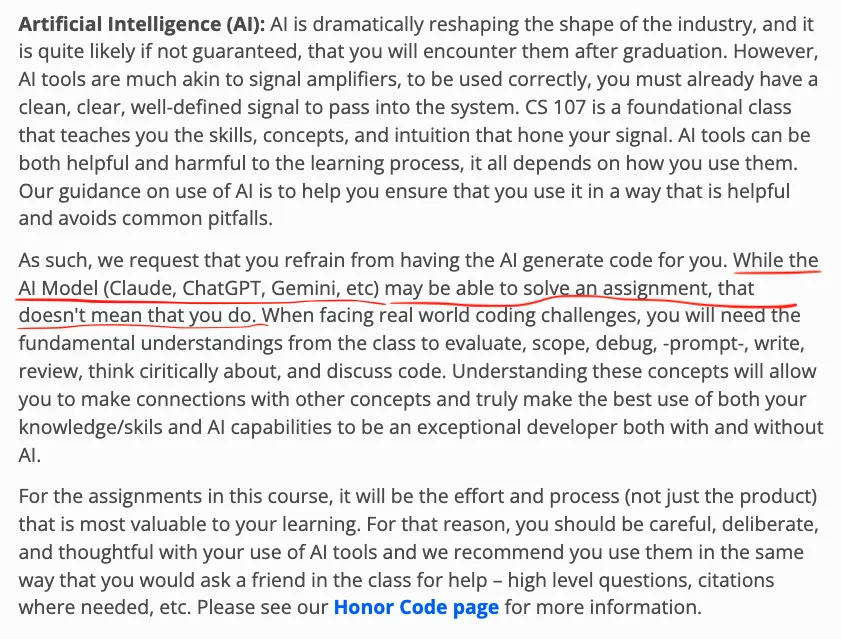
理由也很直接:只有掌握基础,才能评估、调试、审查代码,也才能有效地向 AI 提问。
在 AI 时代,变化也出现在考核方式上。
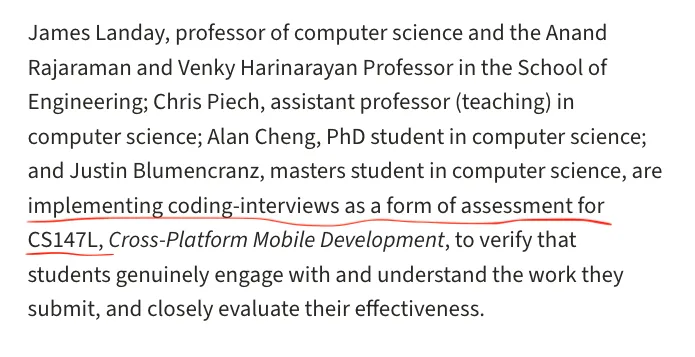
CS147L(跨平台移动开发)和 CS107(计算机组成与系统)都引入了面试考核,不再只靠笔试或项目作业。
即使同学“偷偷”用 AI 交出了一份像样的作业,老师也能通过面试进一步确认:你到底理解了多少?
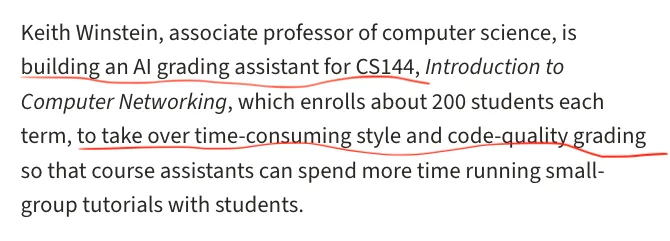
在 CS144(计算机网络导论)中,老师则会用 AI 来评判学生作业的代码风格和质量。
相对“形式化”的作业审查,可以借助 AI 提高效率,老师也就能把更多精力放在更重要的知识辅导上。
整体看下来,我觉得斯坦福对基础课的态度很清楚:
可以使用 AI 辅助学习,但不能用 AI 替代学习;在大多数基础课的编程任务里,学生还是得有“古法编程”的能力,不能只让 AI 生成代码。
聊完非 AI 课程,再来看大家可能更关心的 AI 类课程。
在 AI 类课程中,核心基础课程是CS221,人工智能原理与技术。
这门课程的重点,并不是教你怎样使用最新的大模型,也不是怎样搭建 Agent,更不是关于配置 Skill 或者 MCP 的。
这门课程与我们每天在互联网上看到的 AI 热词,似乎没什么关系。
这门课程涵盖的内容包括机器学习、搜索、马尔可夫决策过程、博弈、约束满足、概率图模型、逻辑推理,等等等等。在我看来,它梳理了人工智能发展历史中的所有重要方法,也在追问一些更基本的底层问题:机器怎样从数据中学习?面对大量可能的选择,怎样找到好的方案?环境有不确定性时,又该如何做决策?
这门课程覆盖的范围,比大模型本身更广。
大模型只是今天解决 AI 问题的一条重要路径,但在很多专门的领域,更古老(或者说更经典)的智能算法,比如搜索、约束求解等,依然有用武之地。
学了这些基础,面对一个具体问题,我们就能知道还有哪些方法可选,各自适合什么条件。
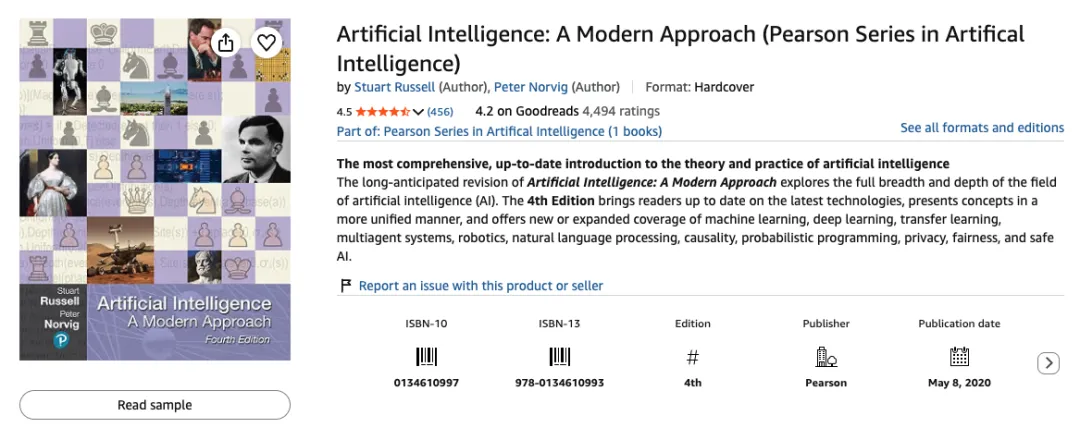
这门课程的推荐教材之一,我以前在公众号上向大家推荐过,就是这本大名鼎鼎的《人工智能:一种现代的方法》。有中文版。
不过要注意,这本书属于比较老旧的大部头经典教材,没有决心认真“从头”学习人工智能的同学,不建议购买。对于大多数同学,还是从 LLM,Agent 这些概念学起比较友好。
 比如,课程中有一个作业,是要做一个智能对话的选课助手。
最靠谱的做法,不是把信息直接喂给大模型,让它替你选课。而是先让大模型理解学生用自然语言表达的需求,生成具体的选课约束条件,再把这些约束交给专门的数学求解程序处理。
这份作业训练的,是先把问题和条件想清楚,再判断适合用什么方法。
以后无论学习大模型,还是开发 Agent,都可以带着这些问题去看新技术:它解决了哪一部分?依赖什么条件?又有哪些困难仍然需要解决?
这又回到了前面那句话:理解基础,才更容易看清一个领域的发展方向。
AI 工具会不断更新。如果学习总是围着“某个产品怎么用”打转,就很容易被一批又一批新名词牵着走。
理解这些方法的原理和适用条件,才更有可能对新技术形成自己的判断。
在这门人工智能基础课之下,斯坦福有许多细分领域的 AI 课程,比如机器学习、自然语言处理、计算机视觉、机器人,等等等等。
对这些课程逐一解读,我觉得普遍意义不大,就不展开了。
但有四门课,我想着重聊聊。它们和我们每天讨论的大模型、Agent、Skill、MCP、上下文工程等话题联系紧密。
关注 AI 的同学,了解一下这些课程在教什么、关注什么,或许能从中获得一些启发。
首先,我要重磅吐血推荐大家关注 CS146S:现代软件开发。
不只是专门做 AI 的同学,所有想用好 AI 编程的同学,都值得看看这门课。
顾名思义,这门课程讲的是如何开发软件。不过,它把与 AI 的协作放到了核心位置。MCP、Agent Skills、上下文工程,以及把产品需求写成可执行的规格,都在它的教学范围内。
我把这门课程的教学大纲截取出来,大家可以感受一下。
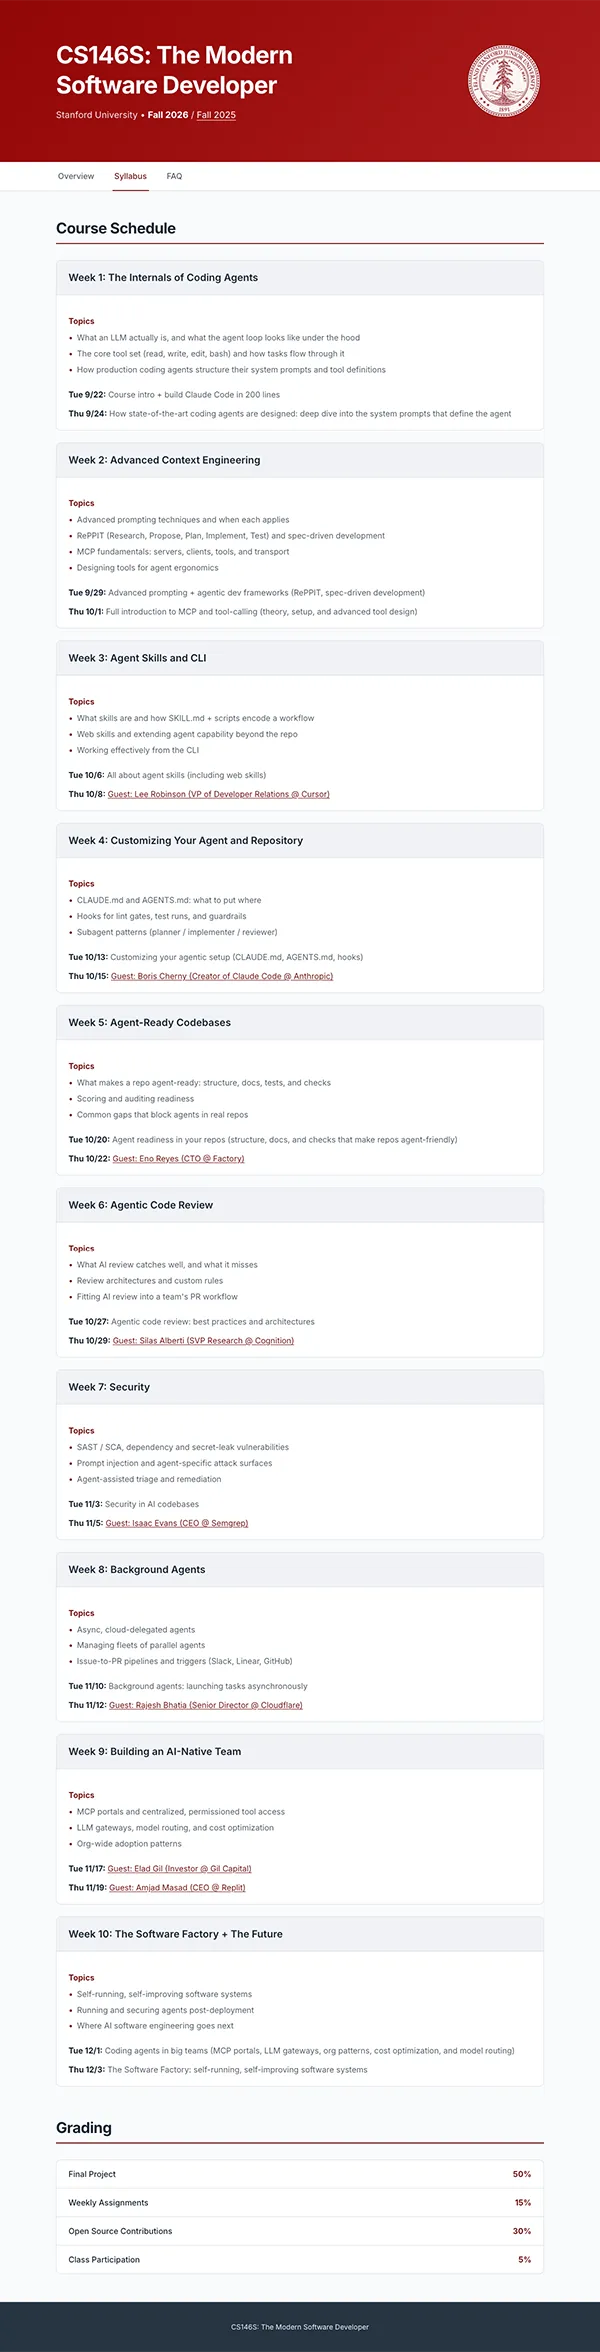
这也从侧面印证了:现代软件开发,已经离不开 AI 了。
AI 可以承担越来越多的代码编写工作。那么,开发者该怎样组织整个开发过程?这是这门课关心的重点。
要给 AI 哪些信息?怎样把模糊的需求说清楚?代码生成以后,又怎样通过测试和反馈继续改进?
如果让我用一句话总结,那就是:会写需求,正在成为编程能力的一部分。
不妨设想一个简单的练习:做一个校园活动报名网站。
你对 AI 说:“帮我做一个报名页面。”
它生成了输入框、按钮和成功提示。页面看起来是做完了。
可问题马上来了。活动只收 30 人,两个人同时抢最后一个名额,怎么办?
有人连续点击两次,算一次还是两次?
取消报名后,名额要不要释放?
这些条件没说清楚,代码就算没有一行语法错误,软件也可能把事情做错。
于是,开发者必须把需求写得更具体:一个账号只能占一个名额;满额后不能继续报名;取消报名,要释放名额;同时也得遵守人数上限;等等等等。
这里很有意思的是“同时抢最后一个名额”这个问题。它涉及典型的并发控制。如果两个请求都读到“还剩一个名额”,随后又都报名成功,就会出现竞争条件 。
没有相关基础,开发者自己都可能意识不到这里存在风险,更谈不上把相应的约束写进需求。开发者怎样才能意识到这些问题?这就又回到了基础。基础越扎实,就越容易发现隐藏在业务需求背后的技术问题。
我坚信,这是未来计算机专业人才的核心竞争力,也是专业和不专业的本质区别。
借助 Vibe Coding,非专业的同学也能做出一个能用的产品;而专业的同学,才有能力把产品做得安全、可靠、稳定。
这也是为什么,这门教学生用 AI 开发软件的课程,仍然要求学生具备 CS111(操作系统)、CS161(算法)等基础课程的知识。
有 AI 参与,开发者依然需要理解自己正在做的系统。
另一门让我非常感兴趣的课程,是CS336:从零构建语言模型。
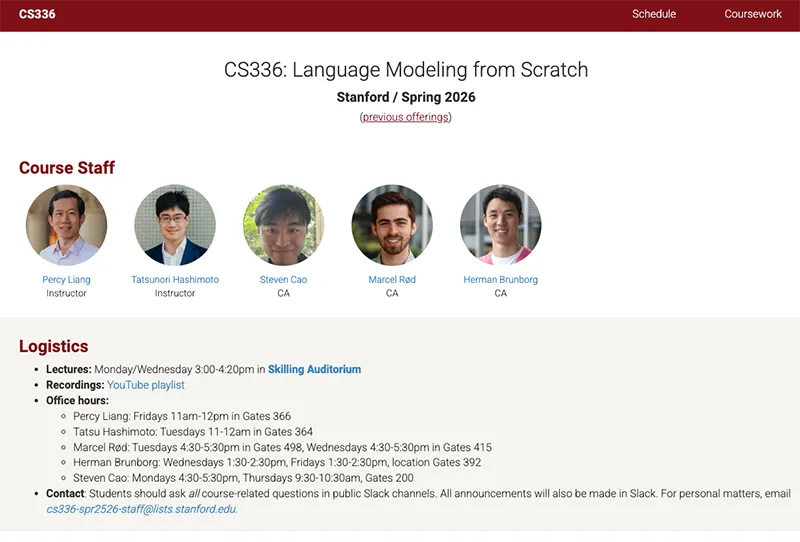
在这门课程中,学生从亲手实现一个分词器开始,逐步搭建语言模型的各个组件,训练一个小型语言模型。接着,还要优化训练效率、处理预训练数据。最后,通过微调和强化学习,训练模型解决数学问题。
很多同学可能都有一个疑问:我们为什么要自己实现一个语言模型?
这门课的介绍里给出了一个很好的类比:学习操作系统时,我们也会亲手实现一个简易操作系统,来理解它是怎么工作的。
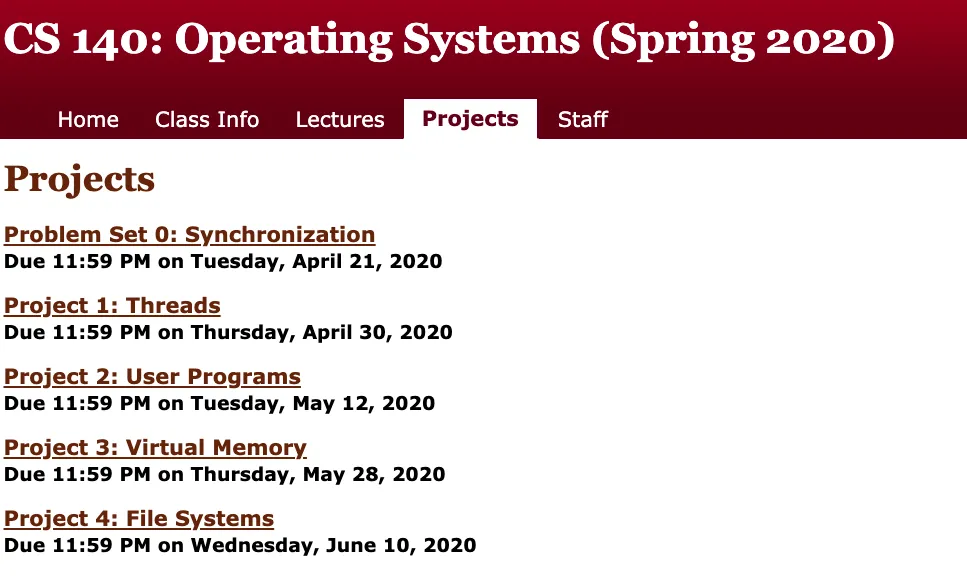
(说到这里,我也想吐血推荐斯坦福的经典操作系统课程 CS140。其 4 个 Projects 的设计,可谓操作系统领域经典中的经典)
学习语言模型也是如此。完整地走一遍开发过程,才更容易看清问题出在哪里:
模型效果不好,可能是数据的问题;
训练速度太慢,可能要检查计算和内存的安排。
很多 AI 问题,最终还是要靠对模型底层的理解来解决。
也正因为如此,CS336 不仅禁止学生使用 AI 生成代码,甚至强烈建议学生做作业时关闭 AI 自动补全。
不借助其他工具,自己从零实现一个语言模型,正是这门课希望学生经历的学习过程。
接下来我想介绍的这门课,就和当下的 Agent 热潮直接相关了:CS329Z,AI Agent 工程。
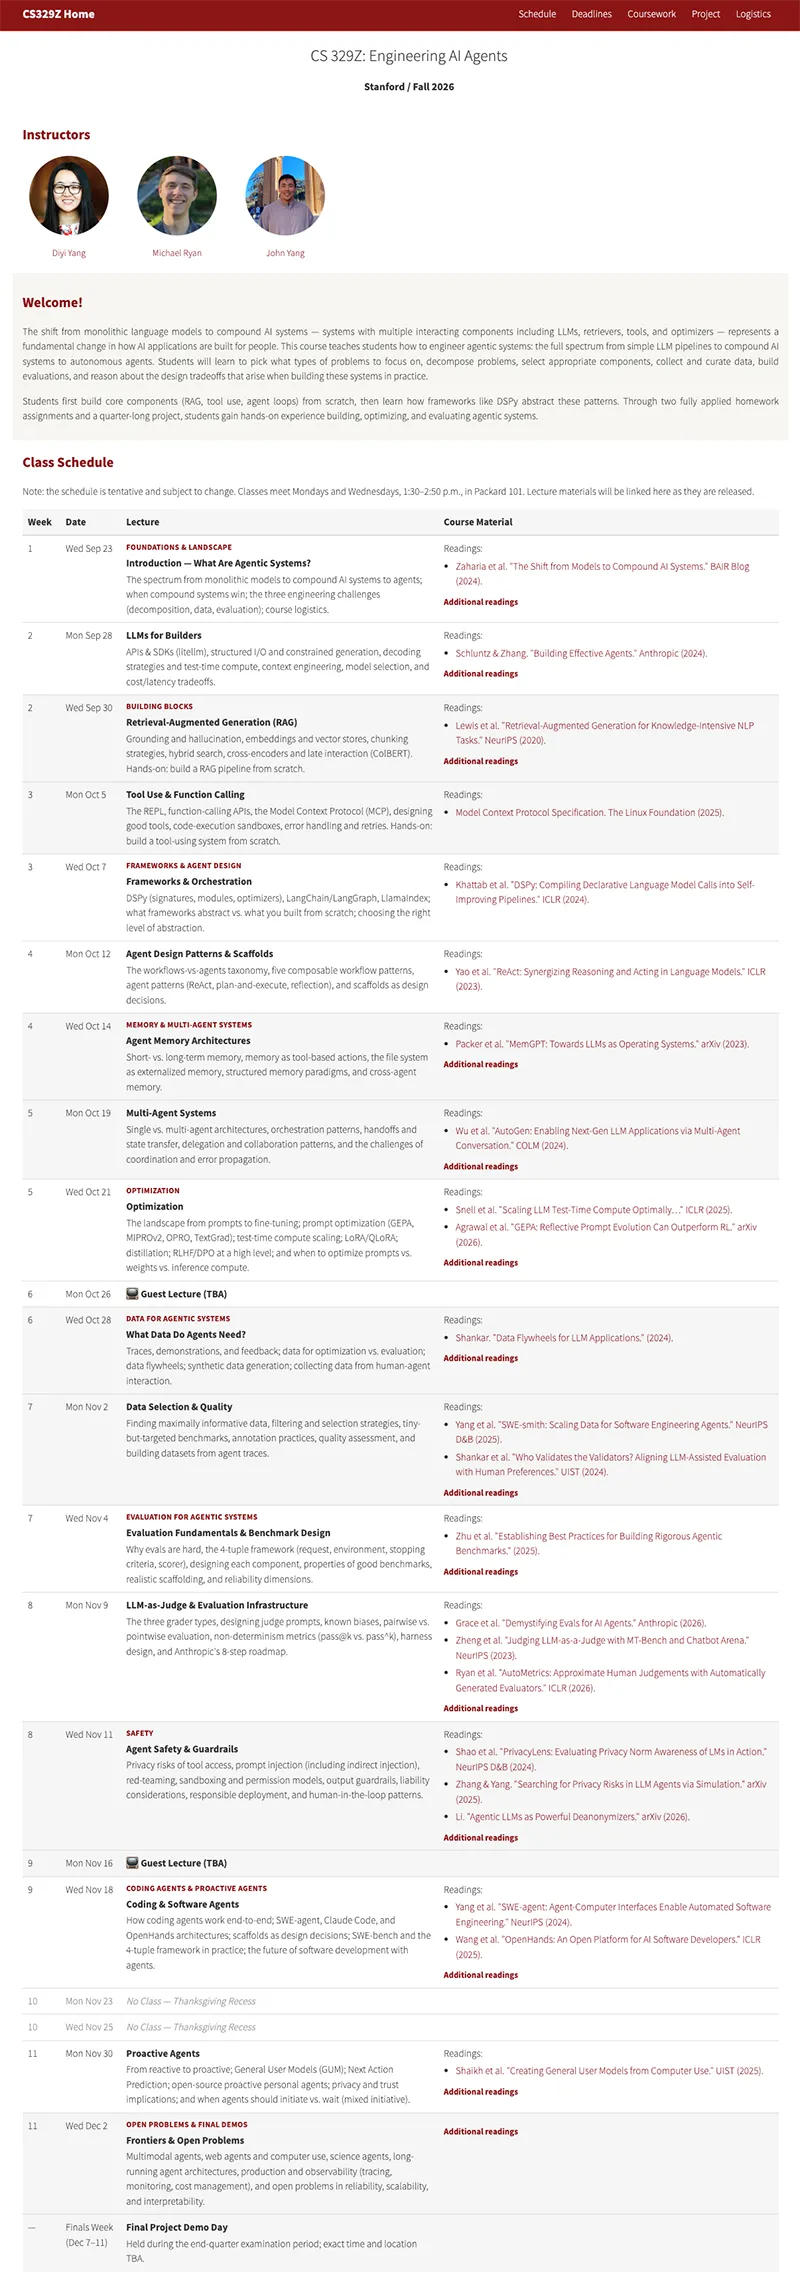
这门课程一共有两个大作业:
第一个大作业,是从零开始搭建一个企业内部 AI 助手。学生先学习 RAG,让系统能从真实的企业邮件中检索资料并回答问题;再逐步加入工具调用、记忆等功能,一步一步扩展 Agent 的能力。
这份作业不允许使用现成的 Agent 框架,但课程中也会介绍 DSPy、LangChain、LangGraph、LlamaIndex 等工具和框架。
这其实是计算机专业里一种经典的学习方法:先自己造轮子,再研究业界成熟的轮子。
亲手实现过,才更容易理解框架替我们做了什么、是怎么做的。遇到问题时,也更容易找到原因。
第二个大作业则完全换了一个方向。学生拿到一个已有的 Agent,要为它设计测试任务和评分办法。
哪些结果可以由程序自动检查?哪些需要让大模型充当裁判?其中至少要包含一种大模型裁判评测,还要分析出错的原因。
这份作业强调的是 Agent 开发中一个越来越受重视的环节:Evaluation,也就是评测。
学习搭建 Agent 时,我们很容易把注意力放在“怎样让它跑起来”。
至于效果怎么样、出了问题怎么检查,却未必会花同样多的精力。
但在现实中,我们不能只看 Agent 是否碰巧完成了一次任务,还要有办法检验它在不同情况下的表现。这就是评测的意义。
我们看到当下很多自媒体演示的 AI 开发的产品,很容易被一次成功的操作吸引。
但真要把它交给别人使用,就需要知道:它在哪些条件下会失败?失败发生在哪个环节?改了以后,怎样确认问题已经解决?
把这些问题解决好,一个 demo才有可能变成可以持续使用的产品。
(顺便吐槽一句:现在自媒体上,很多人展示的那些用 AI 搭出来的东西,更多还是 demo,或者叫 toy,离真正的产品还有距离。)
今年在关于 Agent 的讨论里,明显能看到越来越多的人开始提及 Evaluation 的重要性。这门课的两份大作业中,有一份专门做评测,我觉得非常与时俱进。
说到评测,还得提斯坦福的另一门老牌经典课程:CS224N,基于深度学习的自然语言处理。
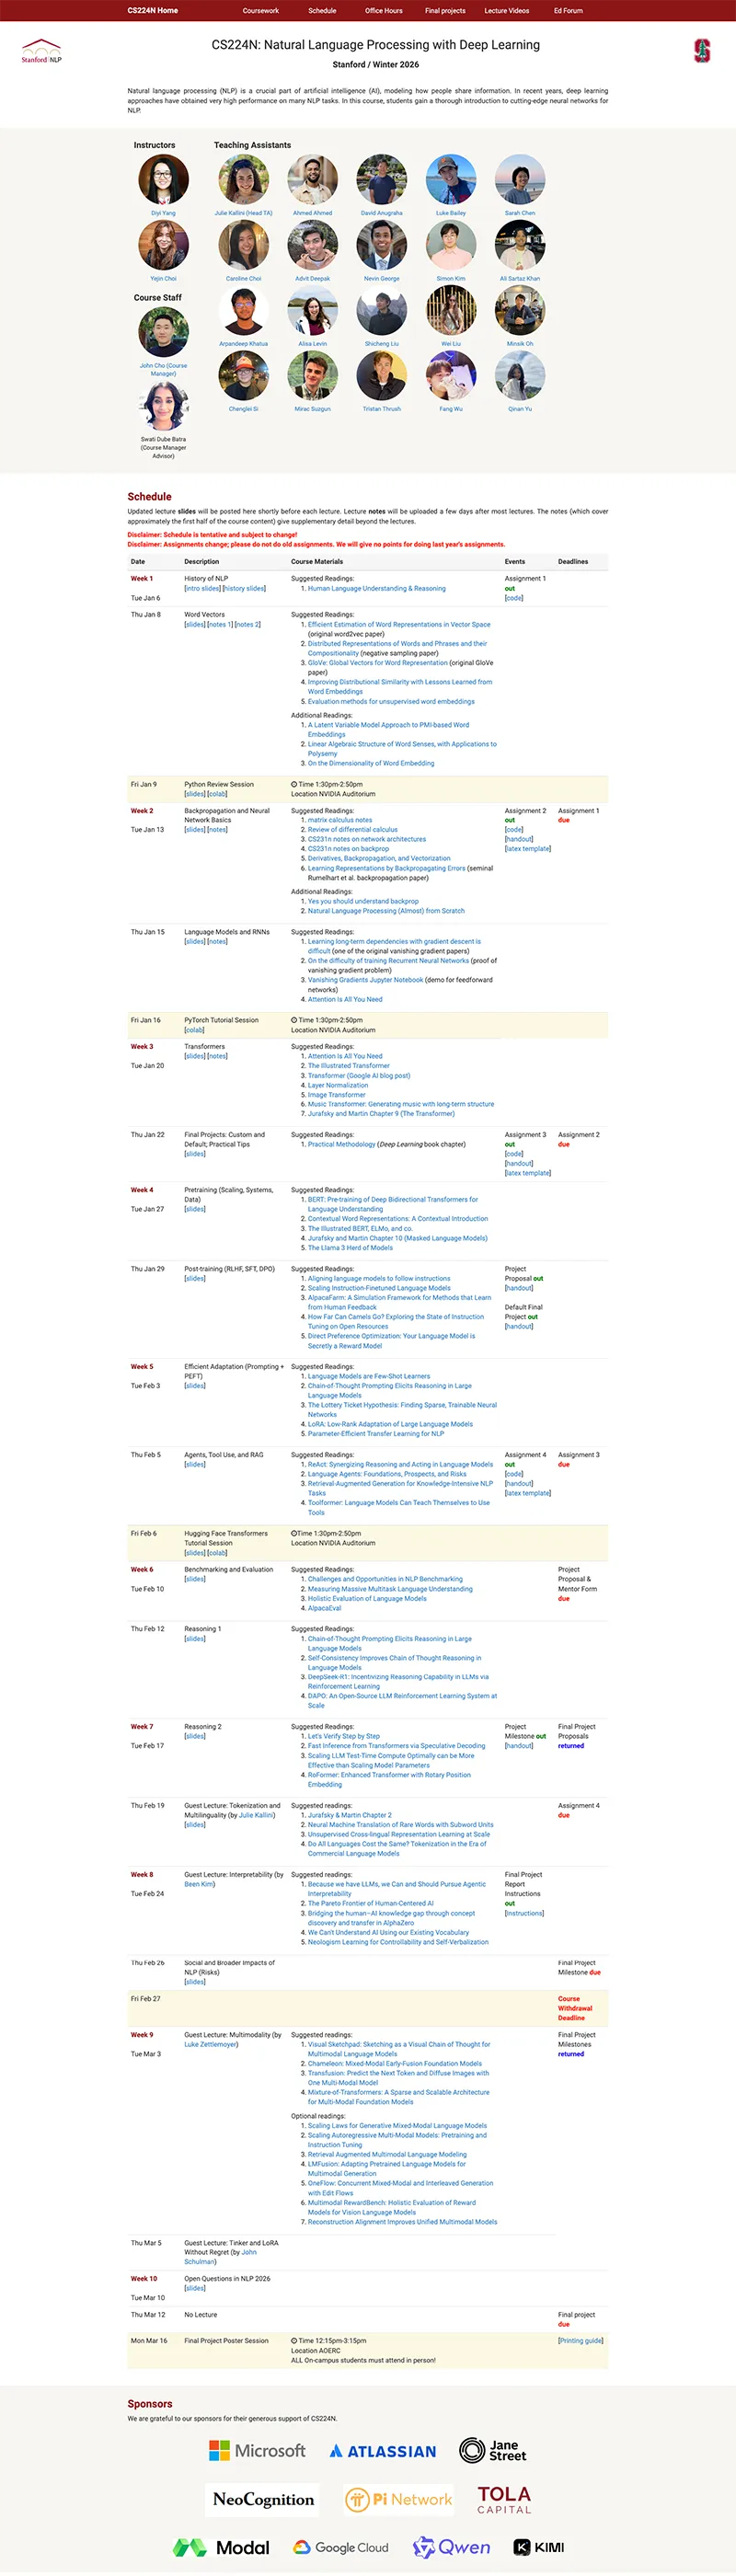
这门课以前只介绍怎样创建一个基于深度学习的语言模型,但现在,它所涉及的内容已经从模型本身,延伸到了模型后训练、Agent、工具调用和 RAG。
近些年的各种新技术,就这样被放进了一个前后连贯的知识体系中。
这门课程的第四次作业,主题也是评测,只不过做的是大模型评测。
学生需要比较模型的表现,尝试修改提示词并检验效果。还要让一个模型充当裁判,评价其他模型的回答。
更有意思的是,作业还会要求学生亲自检查这些判分,找出自己不同意 AI 裁判的例子,并且分析这些“不靠谱”的回答产生的原因。
这里有个很容易被忽略的问题:如果我们用 AI 判断另一个 AI 的好坏,裁判 AI 本身也得接受检查。分数高,未必就意味着产品优秀,对用户的帮助大。
详细理解 AI 自身的局限性,对以后做 AI 产品是非常重要的。
把这些课程放在一起看,我个人觉得:
斯坦福已经在认真训练学生把 AI 纳入软件开发;
也在要求学生理解模型和系统为什么这样工作;
新工具带来的便利写进了课程;
怎样发现它的局限、验证它的效果,也写进了作业。
对普通软件工作者来说,未必人人都要从头训练一个语言模型。但随着 AI 成为开发工具和产品的一部分,理解模型的工作方式、组织人与 AI 的协作,以及评估整个系统的可靠性,会越来越多地进入我们的日常工作。
在我看来,这也是计算机教育正在回应的变化:代码之外,开发者需要理解和负责的事情更多了。
也正因为如此,我完全不认同“计算机专业会没有饭碗”的说法。
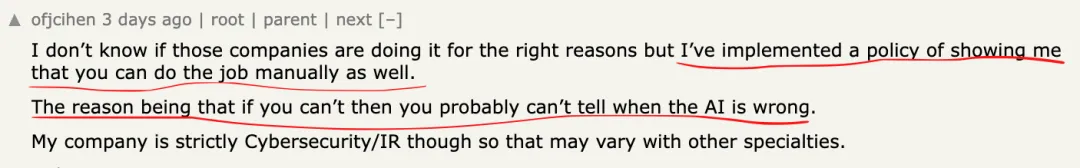
最近,我正好看到一位做安全工作的人,介绍他们公司的招聘策略。
说起来很简单:
首先,要证明你自己能做;
然后,要证明你会用 AI 做。原因也很简单:如果你自己都不会,也就不知道 AI 什么时候错了。
再回头看斯坦福的课程设计,就会发现:他们就是在让学习者留下这两种证据。
第一种证据,证明你自己会。
第二种证据,证明你能与 AI 一起完成更大的任务。
大家加油!:)
P.S.
并非所有斯坦福的课程都是公开课,有公开的课程视频可以看。
但是大部分课程的课程大纲,阅读材料,使用课本,作业信息,全部都是公开的。
这已经非常有参考价值了。
我在 5 年前写过一篇旧文 国外公开课都没视频,怎么办?讲的就是这个问题。感兴趣的同学可以参考。